Server-Side Tracking ist 2026 kein optionaler Baustein mehr, sondern die Grundlage dafür, dass Marketing- und Analytics-Teams in regulierten Märkten überhaupt noch belastbar messen, attribuieren und reporten können. Wer Server-Side Tracking im Pharma-Marketing aufsetzt, entscheidet sich bewusst für eine Architektur, in der Datenschutz-Grundverordnung (DSGVO), Consent-Logik und BI-Governance von Anfang an mitgedacht werden – nicht als nachgelagerte Korrektur.
Inhalt

Warum klassisches Client-Side Tracking 2026 nicht mehr ausreicht
In Pharma-, Healthcare- und Life-Science-Setups laufen Kontaktpunkte über mehr Geräte, Kanäle und Stakeholder verteilt als in fast jeder anderen Branche. HCP-Reichweite über DocCheck, RX-Information über Fachportale, Launch-Kommunikation über Sales-Reps, Follow-up im E-Mail-Marketing und Performance-Sichtbarkeit im Web – jede Station erzeugt Daten, oft in Silos, oft mit eigener Namenslogik. Genau in diesem Umfeld stößt klassisches Client-Side Tracking an harte Grenzen, und Server-Side Tracking wird zur strategischen Notwendigkeit.
Browser-seitiges Tracking lebt von Cookies, lokalen Speichern und Drittanbieter-Domains. Genau diese drei Voraussetzungen werden 2026 systematisch abgebaut: ITP-Regeln verkürzen Cookie-Laufzeiten, Consent-Banner reduzieren die tatsächlich verfügbaren Events, und Ad-Blocker sowie Datenschutz-Add-ons filtern clientseitige Pixel zunehmend heraus. Für diese Architektur bedeutet das: Das Setup, das jahrelang funktioniert hat, liefert nur noch einen Bruchteil der Daten.
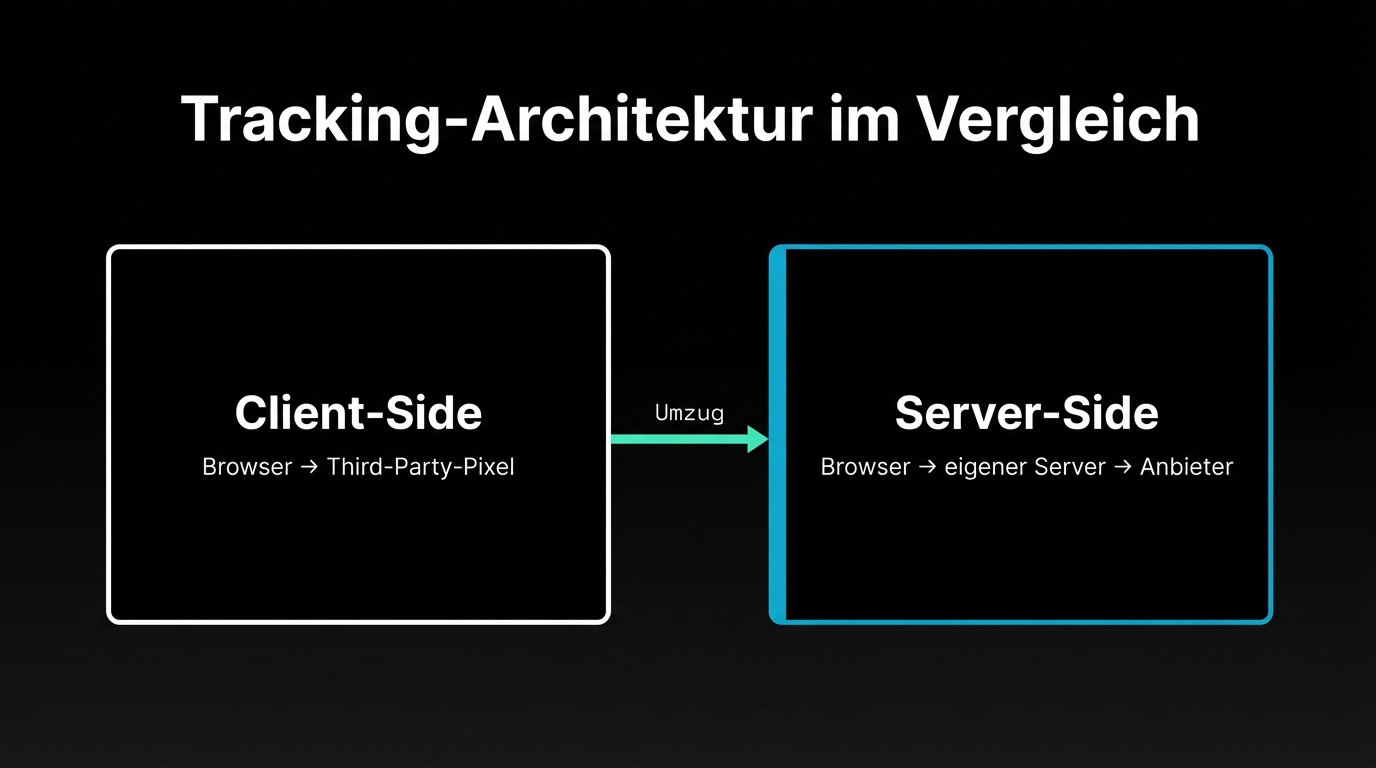
Parallel verlangen Datenschutzaufsicht und interne Compliance zunehmend eine Ende-zu-Ende-Dokumentation des Datenflusses. Bei reinem Client-Side Tracking bleibt dieser Nachweis lückenhaft: Ereignisse entstehen im Browser, fließen über Drittanbieter weiter, verlieren unterwegs Consent-Informationen und sind am Ende der Kette nicht mehr einem konkreten Einwilligungsstatus zuordenbar. Server-Side Tracking setzt genau hier an: Es verlagert Verarbeitung in eine kontrollierte Server-Umgebung, in der Consent-Logik, Datenflüsse und Auditierbarkeit zusammenlaufen.
Baustein 1: Server-Side Container mit klarem Verantwortungsbereich
Der erste Baustein eines belastbaren Setups ist nicht ein Tool, sondern eine Architekturentscheidung. Im Kern steht ein serverseitiger Tagging-Container – typischerweise Google Tag Manager Server-Side oder eine vergleichbare Eigenlösung – in dem eingehende HTTP-Requests validiert, angereichert und an nachgelagerte Systeme weitergeleitet werden. Der eigentliche Wert liegt in dieser Zwischenebene, nicht im Container selbst.
Praktisch heißt das: Browser, App, Server-Backend und CRM senden ihre Roh-Events an einen einzigen Endpunkt. Dort läuft die Geschäftslogik – Consent-Status, Bot-Filter, PII-Hashing, Channel-Normalisierung. Erst danach gehen Daten an GA4, Meta, LinkedIn, ein eigenes Data Warehouse oder ein BI-Tool. Diese Entkopplung ist der architektonische Kern des Setups.
Gerade in regulierten Branchen ist die Ownership-Frage zentral. Wer betreibt den Container? Wer hat Schreibzugriff auf Mappings? Wer entscheidet über den Versand an Drittanbieter? Ohne klare Ownership entsteht genau das, was die Migration eigentlich verhindern soll: ein undurchsichtiger Datenfluss, jetzt nur eine Schicht weiter innen. Deshalb gehört zu Baustein 1 immer ein RACI-Diagramm für den Tagging-Container.
Baustein 2: Google Consent Mode v2 als Brücke zwischen Consent und Messung
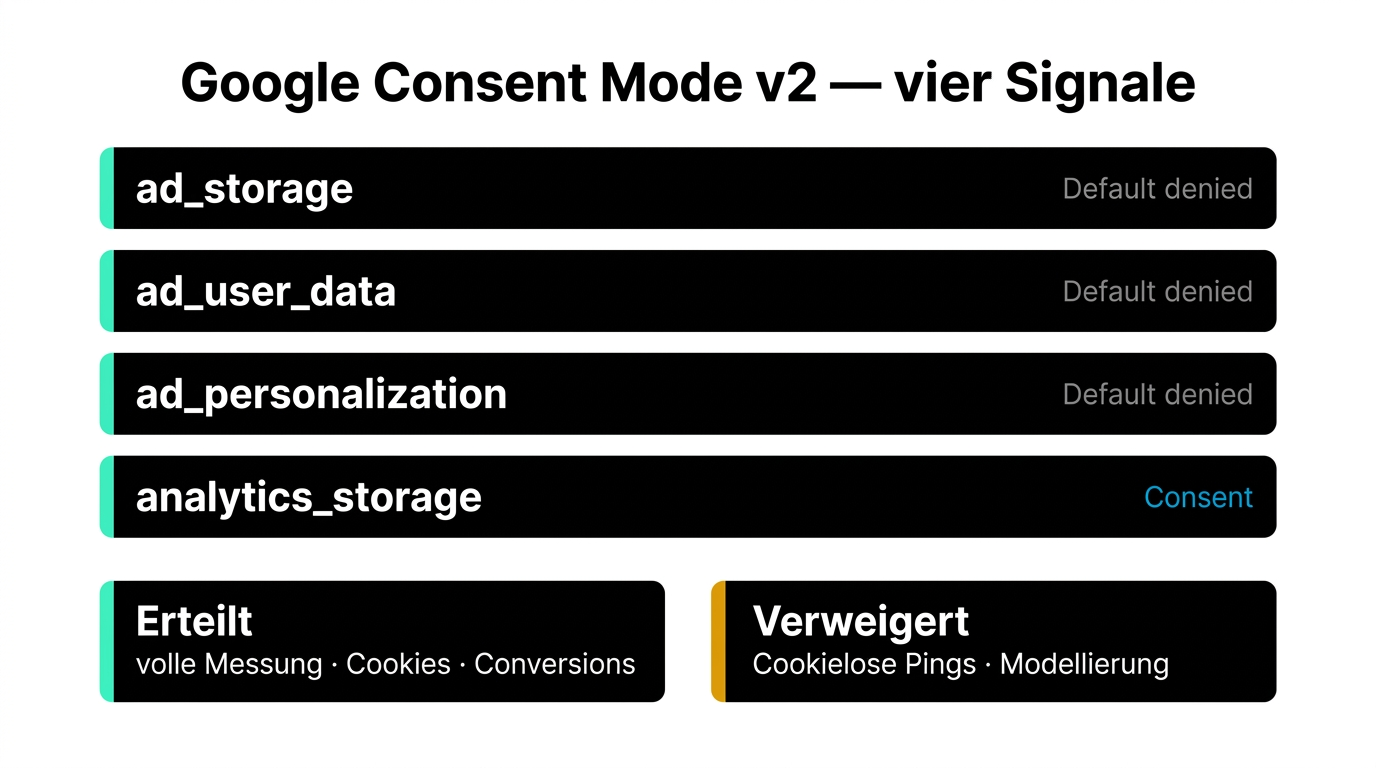
Consent ist die Pflicht, Messung ist die Kür. Die Kunst besteht darin, beides so zu verzahnen, dass die Messarchitektur nicht jedes Mal bricht, wenn ein Nutzer die Einwilligung verweigert. Genau dafür ist Google Consent Mode v2 Dokumentation gebaut. Server-Side Tracking nutzt die vier Signale des Consent Mode v2 (ad_storage, ad_user_data, ad_personalization, analytics_storage), um den Consent-Status serverseitig zu konsolidieren, bevor irgendetwas an Drittanbieter gesendet wird.
Der größte Mehrwert liegt in der Modellierung: Auch bei verweigerter Einwilligung sendet der Container cookielose Pings, die in GA4 und BigQuery als Behavioral-Modelling-Grundlage dienen. So entsteht ein konsistentes Bild des Funnel-Verhaltens, ohne dass die Datenschutzaufsicht einen Verstoss gegen die DSGVO beanstanden kann. Das ist der saubere Mittelweg zwischen lückenhaftem Tracking und vollständigem Tracking-Stopp.
Wichtig ist die korrekte Verdrahtung: Consent-Status kommt aus dem Consent Management Platform (CMP), nicht aus dem Browser direkt. Im Server-Container wird der Status mit Event-Properties zusammengeführt. Nur Events mit dokumentiertem Consent-Status landen im Reporting. Diese Trennung ist nicht nur regulatorisch sinnvoll, sie reduziert auch Diskussionen über Datenqualität im Tagesgeschäft und stärkt das Vertrauen in Server-Side Tracking über die Zeit.
Baustein 3: Conversion API und First-Party-Daten als Fundament
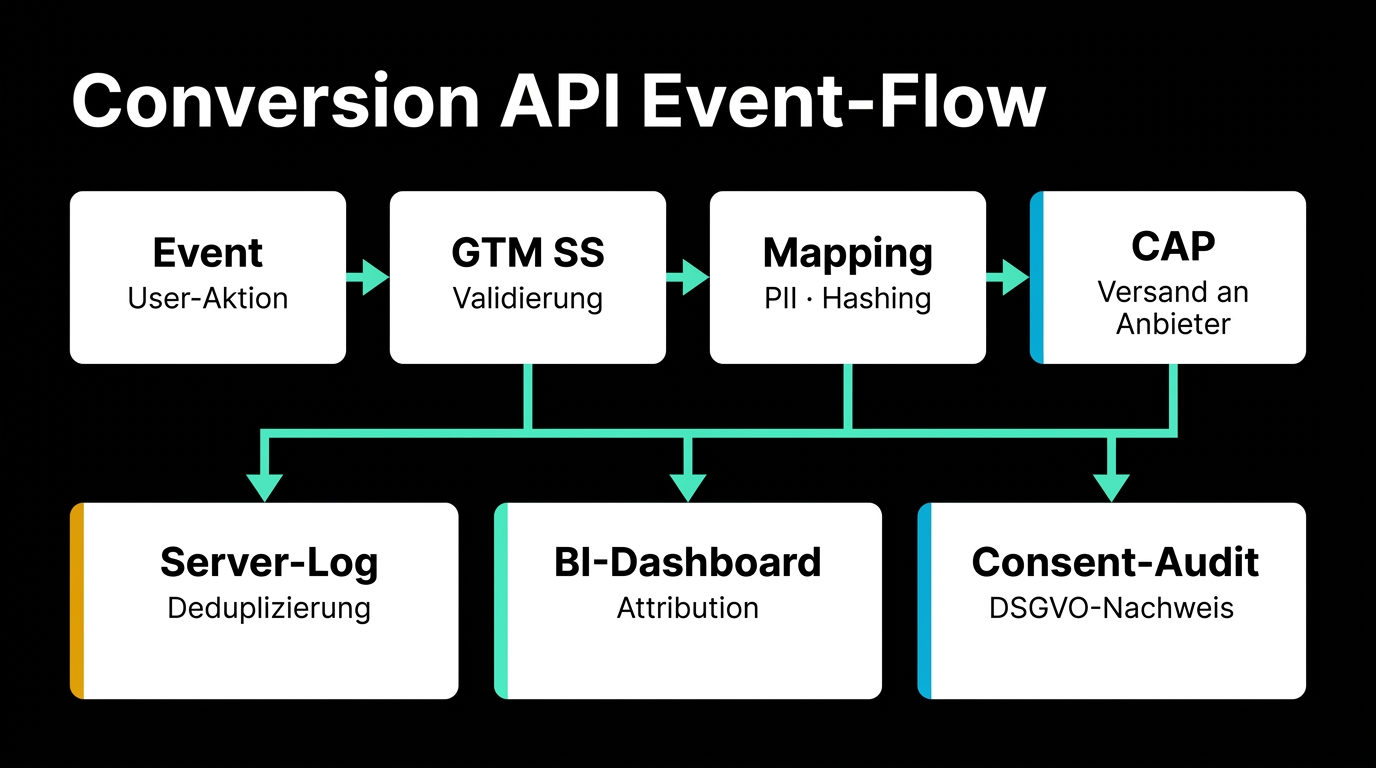
Browser-Pixel allein liefern 2026 kein vollständiges Bild mehr. Die Conversion API – etwa Meta CAPI, LinkedIn Conversions API, Google Enhanced Conversions oder Pinterest Conversions API – ergänzt die clientseitigen Events um serverseitig validierte Conversions. Server-Side Tracking verlangt diesen Brückenschlag, weil nur so HCP-Downloads, Formular-Submissions und Micro-Conversions innerhalb regulierter Journeys vollständig erfasst werden.
Die Konsequenz ist ein verändertes Pflichtenheft für das Marketing-Team: Events entstehen nicht mehr in einem Pixel-Klick, sondern werden vom Server-Container angereichert (User-ID, Consent-Status, Kanalquelle, Timestamp, Hashing). Erst danach geht das Event an die Anbieter-API. Dadurch verschwinden Diskrepanzen zwischen GA4 und den Werbeplattformen – ein Effekt, der im Pharma-Marketing oft über mehrere Prozentpunkte der gemessenen Conversion-Rate entscheidet. Genau darin liegt der operative Nutzen.
First-Party-Daten spielen in diesem Setup eine besondere Rolle. HCP-Zulassungsdaten, Consent-Status, Verifikations-Status (DocCheck-Login) und CRM-Einträge sind First-Party-Hebel, die kein Werbenetzwerk ersetzen kann. In Kombination mit der Conversion API entsteht ein geschlossener Datenkreis, der nicht von Drittanbieter-Cookies abhängt. Der strategische Wert liegt in belastbarer Messung dort, wo der Markt die Datenhoheit Stück für Stück zurückverlangt.
Ein konkretes Beispiel: Eine HCP-Kampagne auf LinkedIn führt auf eine Fachseite mit DocCheck-Zugang und Whitepaper-Download. Im Client-Side-Setup brechen entlang dieser Strecke oft drei Dinge auseinander: der Consent-Status wird nicht sauber mitgeführt, der Download taucht in der Werbeplattform nicht dedupliziert auf, und im CRM fehlt die eindeutige Zuordnung zur Kampagne. Im serverseitigen Setup vergibt der Container eine konsistente Event-ID, prüft den Consent vor der Weitergabe, sendet den Download parallel an GA4, CRM und Conversion API und hält die gleiche Logik auch dann stabil, wenn Browser-Schutzmechanismen einzelne Frontend-Signale unterdrücken.
Baustein 4: Data Taxonomy und saubere Attribution
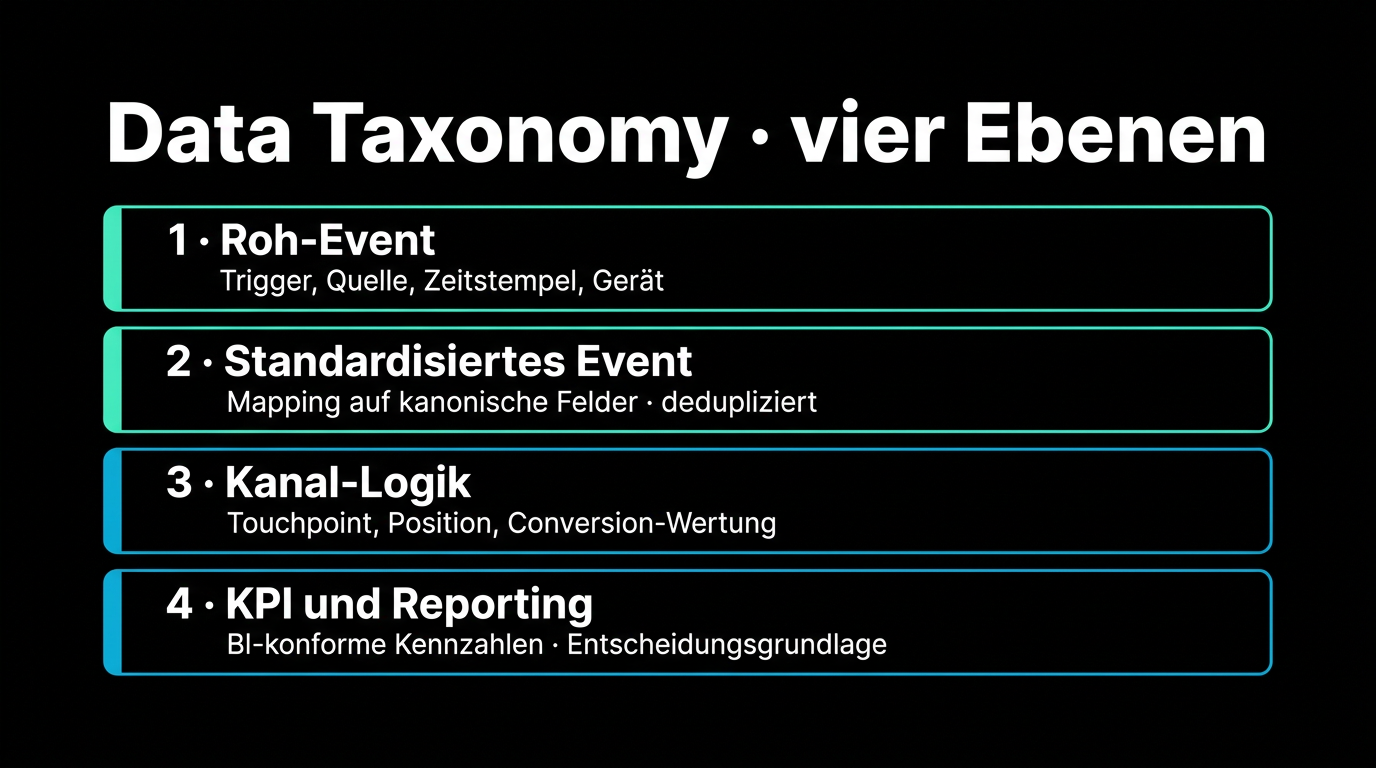
Architektur allein reicht nicht. Wenn jedes Team eigene Event-Namen, eigene Conversion-Definitionen und eigene Kanal-Taxonomien pflegt, hilft der schönste Server-Container nichts. Deshalb ist Baustein 4 die Data Taxonomy – die verbindliche Sprache, in der das Setup Daten erzeugt, anreichert und weitergibt.
Praktisch bedeutet das: ein zentrales Event-Schema, das Roh-Event, standardisiertes Event, Kanal-Logik und KPI trennt. Erst wenn klar ist, dass zum Beispiel ein DocCheck-Login eine Inbound-Conversion, aber keine Marketing-Qualified-Conversion ist, lassen sich Customer Journey-Daten konsistent auswerten. Ohne diese Schicht entstehen genau die Datensilos, die die neue Architektur eigentlich auflösen soll.
Attribution profitiert direkt: Ein einheitliches Event-Schema erlaubt First-Touch-, Last-Touch-, Linear- und Data-Driven-Attribution mit denselben Roh-Daten. Pharma-Marketing-Teams können damit Wirkungsbeiträge verschiedener Kanäle differenzierter bewerten – eine Voraussetzung für Budgetverhandlungen mit Brand- und Performance-Verantwortlichen. Mit jedem zusätzlichen Anbieter, der an das Setup angebunden wird, wächst der Nutzen dieser Schicht.
Baustein 5: BI-Dashboards mit klarer Governance
Daten landen am Ende in Dashboards – und genau dort entscheidet sich, ob eine Architektur operativ genutzt wird oder ob sie zur Architektur-Leiche wird. Die serverseitige Architektur liefert die saubere Datenbasis, aber erst ein BI-Setup mit klarer Governance macht den Unterschied.
Governance heißt in der Praxis: dokumentierte KPI-Definitionen, ein einziges Reporting-Glossar, festgelegte Aktualisierungs-Rhythmen und definierte Owner pro Dashboard. Nur so werden Diskussionen über „die Conversion-Rate ist gesunken” zu Diskussionen über konkrete Veränderungen im Funnel. Suchmaschinenoptimierung (SEO) profitiert übrigens besonders: sauber definierte Page-KPIs lassen sich mit erweiterten Server-Events unterfüttern, ohne dass die Suchmaschinen-Sichtbarkeit Gefahr läuft.
Mindestens genauso wichtig: regelmäßige Datentests. Ein Regressions-Test pro Event prüft wöchentlich, ob die Felder aus dem Server-Container noch im erwarteten Format ankommen. Klingt banal, verhindert aber den häufigsten Auslöser für „das Reporting ist kaputt”-Tickets. Wird das mit einem klaren Eskalationspfad kombiniert, ist die BI-Seite auf einem Niveau, das Marketing- und IT-Teams gleichermaßen vertrauen können.
Was Server-Side Tracking nicht automatisch löst
Bei aller Euphorie: Ein Server-Container macht noch keine gute Strategie. Wenn Touchpoint-Definitionen unklar sind, wenn Conversion-Events nicht zur Geschäftslogik passen oder wenn Datenschutz- und Compliance-Vorgaben weiterhin in Silos gepflegt werden, hilft auch das beste Server-Side Tracking-Setup nicht. Es ist ein Verstärker, kein Ersatz.
Ebenso wenig ersetzt die Architektur eine funktionierende Abstimmung zwischen Marketing-, Analytics-, IT- und Legal-Teams. Die Architektur lebt davon, dass die Ownership klar ist – wer darf ein Event umbenennen, wer ein neues Feld einführen, wer entscheidet über Datenfreigaben. Ohne diese Klärung wird aus dem Server-Container ein weiteres Datensilo mit komplexerer Schnittstelle.
Nächste Schritte für Marketing- und IT-Teams
Eine solche Architektur lässt sich nicht in einem Sprint einführen. Wer pragmatisch starten will, geht in dieser Reihenfolge vor: erst Consent-Lücken im CMP schließen, dann die kritischen Server-Events definieren, dann den Container pilotieren, dann schrittweise Migration. Jede Stufe erzeugt sofort nutzbare Insights und reduziert das Risiko eines Big-Bang-Rollouts.
- Audit der aktuellen Consent-Erfassung und Lückenanalyse gegenüber Consent Mode v2.
- Inventur der vorhandenen Tracking-Events und Identifikation der Top-10-Conversion-Pfade.
- Aufsetzen eines Server-Containers in einer Staging-Umgebung inklusive Logging und Monitoring.
- Pilotmigration von 2–3 Events, Vergleich der Datenqualität, dann sukzessive Erweiterung.
- Definition eines Data-Taxonomy-Schemas mit eindeutigen Owner pro Event und KPI.
- Aufbau oder Erweiterung der BI-Dashboards mit Governance-Dokumentation und Regressions-Tests.
Fazit: Ein belastbares Fundament
Wer 2026 im Pharma-Marketing verlässlich messen, attribuieren und reporten will, kommt an der serverseitigen Architektur nicht vorbei. Nicht als Trend, sondern als Voraussetzung für saubere Messung, belastbare Datenflüsse und eine BI-Architektur, die operative und strategische Entscheidungen trägt. Die fünf Bausteine – Container, Consent Mode, Conversion API, Data Taxonomy und BI-Governance – greifen ineinander. Wer sie zusammen denkt, schafft ein Fundament, das auch dann trägt, wenn sich Drittanbieter-Cookies, Browser-Regeln und Consent-Pflichten weiter verändern. Genau das ist der Anspruch, mit dem MINTT Digital DACH-Teams aus Healthcare, Pharma und Life Sciences begleitet, wenn es um serverseitige Messarchitekturen geht.
Wenn Sie prüfen möchten, wie ein solches Setup in Ihrer Organisation konkret aussehen kann, spricht MINTT Digital gern mit Ihnen über Tracking & Analytics, BI-Dashboards und eine Omnichannel-Strategie mit klarer Messlogik.
Häufige Stolperfallen beim Setup in der Praxis
Wer ein solches Setup zum ersten Mal produktiv bringt, stolpert fast immer über dieselben drei Fallstricke. Sie fallen erst auf, wenn das System bereits Conversions liefert – und lassen sich dann nur mit Migrationsaufwand zurückdrehen. Wer sie kennt, plant sie von Anfang an weg.
Stolperfalle 1: Mapping wird zur Black Box. Sobald der Server-Container Events anreichert, schleichen sich inkrementelle Sonderlocken ein. Ein Feld wird umbenannt, ein Channel-Mapping wird nachjustiert, ein Drittanbieter erhält ein zusätzliches Property – und nach sechs Monaten ist nicht mehr rekonstruierbar, woher ein bestimmtes Feld kommt. Die Folge: Diskussionen über Datenqualität, die niemand auflösen kann, weil das Mapping-Diff in keinem Git-Repo liegt. Gegenmittel: jede Mapping-Änderung als versionierte Konfiguration behandeln, Review-Prozess etablieren, Mapping-Tests im CI/CD-Lauf mitziehen.
Stolperfalle 2: Consent wird im Browser geprüft, nicht im Container. Viele Setups lesen den Consent-Status direkt aus dem Browser, also aus dem Pixel-Klick. Das hat zwei Nachteile: Erstens kann der Status serverseitig nicht mehr nachvollzogen werden, zweitens landen Events von Browsern mit restriktiver Privacy-Konfiguration ohne Consent-Information im Container. Gegenmittel: Consent-Information serverseitig anreichern, idealerweise per signiertem Token aus dem CMP, und im Container explizit validieren, dass jedes Event einen dokumentierten Consent-Status mitführt.
Stolperfalle 3: Conversion API wird nur als Backup verstanden. Wenn die Conversion API als Notnagel für verlorene Pixel-Events läuft, ist sie schlecht verdrahtet: Mapping ist unvollständig, Deduplizierung fehlt, Event-IDs werden nicht mitgeführt. In der Folge entstehen Diskrepanzen, die niemand erklären kann. Gegenmittel: Conversion API von Anfang an als gleichberechtigter Pfad behandeln, Event-IDs vergeben, Deduplizierung am Anbieter konsequent aktivieren, regelmäßig gegen Pixel-Events abgleichen.
Neben diesen drei Klassikern gibt es eine Reihe kleinerer Fallen, die sich summieren: fehlende UTC-Normalisierung in Events, die später in mehreren Zeitzonen interpretiert werden; Session-Logik, die im Container anders läuft als im Browser; Custom Dimensions, die zwar in GA4 landen, aber nicht in der BI-Schicht; fehlende Hashing-Konventionen für PII. Jede einzelne ist lösbar, in der Summe kosten sie Wochen. Wer die Architektur einführt, sollte für die ersten zwei Quartale eine dedizierte Cleanup-Schicht einplanen – und die Erkenntnis akzeptieren, dass saubere Messarchitektur ein laufender Prozess ist, kein Einmalprojekt.
Gerade im regulierten Umfeld kommen zu diesen drei Kernfehlern noch zwei Zusatzthemen hinzu: HCP-spezifische Daten dürfen nur an freigegebene Plattformen fließen, und First-Party-IDs müssen auch in Browsern mit restriktiven Privacy-Einstellungen stabil bleiben. Deshalb lohnt sich ein fester Review-Rhythmus mit monatlichem Sanity-Check der wichtigsten Conversion-Pfade, quartalsweiser Prüfung von Mapping und Consent-Weitergabe sowie einem halbjährlichen Governance-Audit.
Häufige Fragen zu Server-Side Tracking
Was unterscheidet es vom klassischen Client-Side Tracking?
Beim Client-Side Tracking laufen Messungen direkt im Browser. Bei der serverseitigen Variante werden Events in einer kontrollierten Server-Umgebung verarbeitet, validiert und an Drittanbieter weitergeleitet. Das verschiebt die Datenhoheit, schafft Auditierbarkeit und reduziert die Abhängigkeit von Browser-Mechanismen.
Ist die serverseitige Architektur DSGVO-konform?
Die Architektur ist DSGVO-konform umsetzbar, sofern der Server-Container Consent-Status nachvollziehbar verarbeitet, PII gehasht und nur rechtmäßige Events an Drittanbieter sendet. Die DSGVO-Konformität hängt nicht am Tool, sondern an der sauberen Verdrahtung mit dem CMP und einem dokumentierten Audit-Pfad.
Brauche ich für die serverseitige Architektur zwingend Google Tag Manager Server-Side?
Nein. GTM Server-Side ist eine verbreitete Option, aber nicht die einzige. Auch Eigenlösungen auf Basis von Cloud Functions, AWS Lambda oder einer Middleware-Layer-Architektur sind möglich. Wichtig ist, dass Consent-Logik, Validierung und Routing zentral an einer Stelle laufen.
Wie lange dauert eine Einführung der serverseitigen Architektur?
Für eine Pilotstrecke mit den wichtigsten 2–3 Events rechnen Sie je nach Reifegrad der Datenarchitektur mit 4–8 Wochen. Eine vollständige Migration dauert typischerweise ein bis zwei Quartale, weil nicht nur die Architektur, sondern auch Data Taxonomy und BI-Governance umgestellt werden.
Welche KPIs profitieren am meisten von der serverseitigen Architektur?
Insbesondere Conversion- und Attributions-KPIs, die im Client-Side Setup systematisch untersucht wurden: Channel-Attribution, Multi-Touch-Conversions, Funnel-Geschwindigkeit, HCP-Qualifizierung und Compliance-bezogene Audit-KPIs. Auch Performance-Vergleiche zwischen Meta, LinkedIn und GA4 werden aussagekräftiger, weil Diskrepanzen durch Deduplizierung am Server-Endpoint verschwinden.